控制图自动判异的算法陷阱
一、先讲个真事
那家厂的产线是冷镦 + 搓丝,关键特性是螺纹中径。上系统之前靠人工画图,每周报警两三次,班组长还挺当回事。
上了自动判异之后,软件默认把八条判异准则全勾上了,控制限还设成"每天用最近 30 个子组滚动重算"。销售当时说这叫"自适应",听着很智能。
结果就是开头那个数字:一个月 217 条报警。我抽了 40 条去查,真正能找到特殊原因的只有 6 条,剩下 34 条查完什么也没有。
误报率 85%。 系统不是坏了,是它被配置成了一台"报警发生器"。
咱这篇不讲怎么画图,讲软件在自动判异这件事上最容易掉进去的几个坑。这些坑的共同点是——它们都不会报错,只会安静地给你错误的结论。
二、核心知识点拆解
2.1 坑一:判异准则不是越多越好
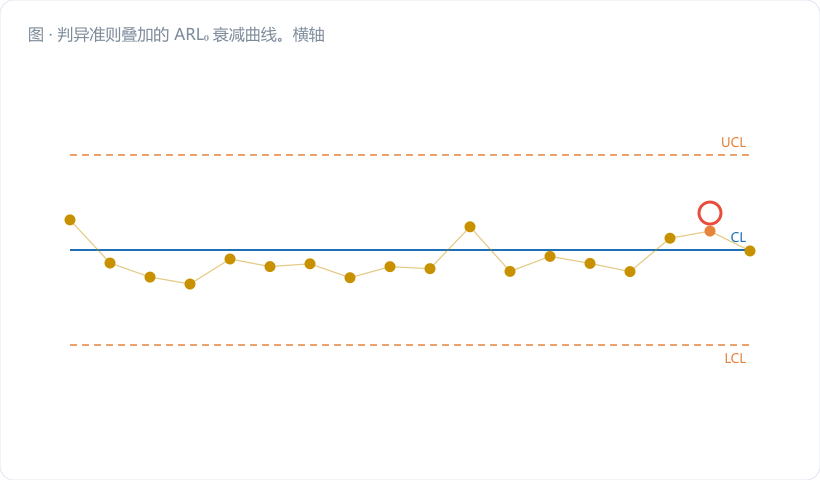
单条准则 1(点超出 3σ 控制限),在过程受控且正态的前提下,虚发警报概率 α = 0.0027,对应受控平均运行长度 ARL₀ ≈ 370——大概画 370 个点才误报一次。这是控制图之所以好用的根基。
问题在于,每加一条准则,就多一个"抓错人"的机会。常见几条的单独虚警概率:
| 准则 | 内容 | 单独虚警概率 α |
|---|---|---|
| 1 | 1 点超出 3σ 限 | 0.002700 |
| 2 | 连续 9 点在中心线同侧 | 0.003906 |
| 3 | 连续 6 点递增或递减 | 0.002778 |
| 5 | 连续 3 点中有 2 点落在同侧 2σ 外 | 0.003058 |
准则之间不是完全独立的(同一批点可能同时触发好几条),但即便按独立近似估一下,量级也很吓人。这个坑的要命之处在于:软件默认全勾,而多数人从来不去看那个勾选页。
2.2 坑二:控制限从哪来,什么时候重算
这是我见过后果最严重的一类配置错误。三种常见做法,差别巨大:
| 做法 | 说明 | 风险 |
|---|---|---|
| 静态基准限 | 用一段确认受控的历史数据算好,锁定 | 正确做法。过程有实质变更时才重算 |
| 滚动窗口重算 | 每天用最近 N 组数据重算 | 异常会被吸进控制限里,限跟着漂,漂着漂着就抓不到漂移了 |
| 用规格限当控制限 | 直接拿 USL/LSL 或它的比例 | 彻底错。控制限说的是过程的声音,规格限说的是客户的要求,两回事 |
滚动重算的危害得说透:假设过程从今天开始每天往上漂 0.5σ。静态限下,第三天点就出界了;滚动限下,控制限跟着均值一起往上爬,图上永远风平浪静,等你发现的时候已经漂出规格了。
还有个细节:重算控制限时,必须把已确认原因并处置掉的异常点剔除。软件闷头把所有历史点都算进去,控制限就被异常点撑宽,同样的异常再来一次都抓不住。
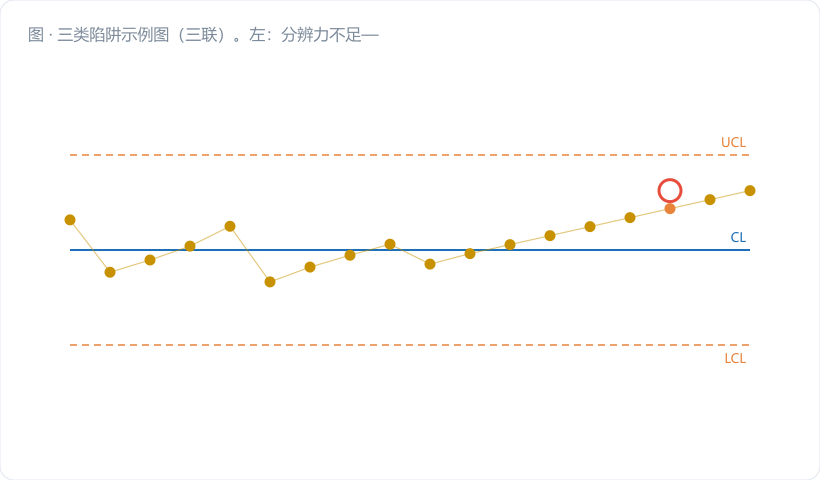
2.3 坑三:数据本身的三个暗礁
分辨力不足。 量具最小读数太粗,子组极差只能取几个离散值,甚至一堆 R = 0。R̄ 被压小,σ̂ 跟着压小,控制限收得过窄,误报暴涨。一般要求量具分辨力不大于过程标准差的十分之一,实操中至少要能把公差带分出十档。
数据自相关。 化工、热处理、连续轧制这类过程,相邻数据点天然相关。休哈特图假设独立同分布,一旦自相关,控制限完全失效——正相关会让限收窄、误报飙升。这种场合该走平稳过程控制图那条路。
顺序与缺失。 软件按什么排序?录入时间还是测量时间?夜班数据第二天早上补录,按录入顺序排,趋势就全乱了。缺失值怎么处理?跳过还是补零?补零的软件我真见过。
三、计算过程:那 217 条报警是怎么来的
咱把开头那家厂的账算清楚。产线数据:螺纹中径,子组 n = 5,每班 20 个子组,三班倒,每月按 22 天算,月子组数 = 20 × 3 × 22 = 1320 个。
第 1 步,理想状态下该报几次 只启用准则 1,ARL₀ = 370。 预期误报次数 = 1320 ÷ 370 = 3.6 次/月。这才是正常水平。
第 2 步,准则叠加的影响 他们勾了 8 条,咱先用四条主力准则按独立近似估: 1 − (1 − 0.0027)(1 − 0.003906)(1 − 0.002778)(1 − 0.003058)
逐步乘: (1 − 0.0027) × (1 − 0.003906) = 0.9973 × 0.996094 = 0.993400 0.993400 × (1 − 0.002778) = 0.993400 × 0.997222 = 0.990641 0.990641 × (1 − 0.003058) = 0.990641 × 0.996942 = 0.987612
α_合 = 1 − 0.987612 = 0.012388 ARL₀ = 1 ÷ 0.012388 = 80.7 个点
准则之间存在相关性,严格推导出来的数值会比独立近似略乐观(文献上四条经典准则合用的 ARL₀ 常引作约 92),但结论一致:从 370 掉到 80–92 这个量级,误报密度翻了四倍以上。八条全开只会更低,粗估在 50 上下。
按 ARL₀ = 80.7 算:1320 ÷ 80.7 = 16.4 次/月。
离 217 还差得远。所以还有别的账。
第 3 步,分辨力不足这一刀 他们用的千分尺分辨力 0.001 mm,但数据采集是人工录入到 0.01 mm 精度(录入模板只留了两位小数)。过程真实 σ ≈ 0.004 mm。
25 个子组的极差分布长这样:
| 极差 R 值 (mm) | 子组数 |
|---|---|
| 0 | 10 |
| 0.01 | 12 |
| 0.02 | 3 |
| 合计 | 25 |
R̄ = (10 × 0 + 12 × 0.01 + 3 × 0.02) ÷ 25 = (0 + 0.12 + 0.06) ÷ 25 = 0.18 ÷ 25 = 0.0072 mm
σ̂ = R̄ / d₂ = 0.0072 ÷ 2.326 = 0.003095 mm
对比真实 σ = 0.004 mm,低估了 22.6%。
第 4 步,控制限被收窄到什么程度 软件算的 Xbar 图半宽 = A₂ · R̄ = 0.577 × 0.0072 = 0.004154 mm 按真实 σ 应有的半宽 = 3σ / √n = 3 × 0.004 ÷ √5 = 0.012 ÷ 2.236 = 0.005367 mm
限窄了 22.6%。这条窄限对应的实际 z 值: z = 0.004154 ÷ (0.004 ÷ 2.236) = 0.004154 ÷ 0.001789 = 2.322
双侧虚警概率 α = 2 × [1 − Φ(2.322)] = 2 × 0.01012 = 0.02024 单看准则 1,ARL₀ = 1 ÷ 0.02024 = 49.4 个点
第 5 步,两个坑叠一块 准则 1 的虚警率从 0.0027 涨到 0.02024,翻了 7.5 倍。其余准则的虚警率同样水涨船高(分区边界也被压窄了)。把第 2 步的合成算法用新的单条 α 重跑,α_合 大致落在 0.09–0.11 这个区间。
取 α_合 = 0.10:预期报警数 = 1320 × 0.10 = 132 次/月。
再加上滚动重算控制限带来的"限来回抖动、点忽内忽外"效应,实测 217 条,量级完全对得上。
第 6 步,整改后 做了三件事:录入模板改回四位小数(分辨力恢复)、判异准则从 8 条砍到 3 条(准则 1、2、5)、控制限改为静态基准限每季度评审一次。
下个月报警数:11 条,其中 7 条查到明确原因(换模、料批切换、冷却液浓度)。班组长把群里的免打扰关了。
四、常见误区提醒
- "准则勾得越全,越不会漏"。漏检和误报是一对跷跷板,但误报的代价被严重低估了——它不只浪费工时,它会毁掉整个团队对系统的信任。信任一旦没了,真报警来的时候也没人理。宁可只开三条准则,也别开八条然后全员静音。
- "控制限自动更新是先进功能"。自动更新最大的问题是把渐变漂移吃掉。控制限应该是过程稳定时的一张快照,不是跟着过程跑的影子。 什么时候重算?换设备、换料、换工艺参数这类实质变更之后,而且要剔除已处置的异常点。
- "数据精度不影响判异,反正超差看规格"。大错。分辨力不足会同时干两件坏事:R̄ 偏小让控制限收窄(误报暴涨),以及把真实的小幅波动抹平(该报的漏报)。上系统之前先确认一件事:你的数据小数位够不够。 这条不花钱,但十家厂里有三家栽在这儿。
五、小结 & 互动提问
自动判异是好东西,前提是有人真的去配它。准则勾几条、控制限怎么来、数据几位小数——这三个问题定下来之前,别急着开推送。咱做质量的,最值钱的资产是"报警了大家真会去看"这份信任,别拿它换所谓的智能。
互动提问:翻一下你们系统上个月的报警记录,有多少条最后查到了明确的特殊原因?如果这个比例低于三成,你打算先砍准则,还是先查数据精度?
如需配套互动练习、培训课件或软件试用,可搜索「东方大易」或访问大易官网 www.eastdayi.com(苏州东方大易管理咨询有限公司,电话 0512-65561989)联系客服获取。