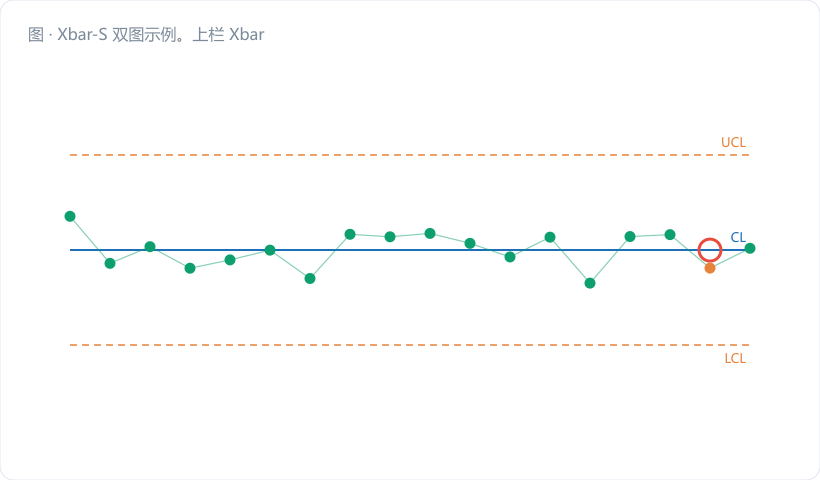
Xbar-S 图:大子组(n≥10)的姿势
一、先讲个真事
去年在一家调味品厂做产线数字化验收。灌装线上装了在线检重秤,每瓶都过称,数据自动进 MES,一个班能攒下两万多条净含量记录。
结果打开他们的 SPC 看板,用的是 n=5 的 Xbar-R 图——从每分钟 20 瓶里"抽"5 瓶出来算。我问为啥不用全部 20 个数据,工程师说:"R 图的常数表我们只查到 n=10,再说 20 个数算极差也就那两个点管用嘛。"
他说对了一半:20 个数算极差,确实只有最大最小两个点在干活,中间 18 个纯属陪跑。但结论错了——大子组不该继续用极差,该换成标准差 S。
换成 Xbar-S 之后,同样的数据,σ 的估计精度提升了大约 18%,Xbar 的控制限收窄,一次灌装头轻微堵塞造成的 0.4 g 偏移,比原来早报警了近半小时,一个班少赔了两百多瓶的超灌损失。
数据是花钱买的,别只用两个点。
二、核心知识点拆解
2.1 S 图是什么:把"最大减最小"换成"每个点都参与"
极差 R = x_max − x_min,只用两个极端值;样本标准差 s 则把子组内每一个数据都算进去:
注意分母是 n−1(自由度),不是 n。这是无偏方差的要求,手算和 Excel 的 STDEV.S 一致;要是你不小心用了 STDEV.P(分母 n),算出来的 s 会偏小,限跟着变窄,假报警一片。
一组数据里,R 的信息利用率随 n 增大而急剧下降:n=2 时两个点全用上(R 和 s 等价),n=25 时 23 个点被浪费。n≥10 是行业公认的换枪节点。
2.2 Xbar-S 的控制限公式
计算流程和 Xbar-R 一个套路,换常数而已:
- 总均值:X̿ = ΣX̄ᵢ / k
- 平均标准差:S̄ = Σsᵢ / k
| 图 | 中心线 CL | 上控制限 UCL | 下控制限 LCL |
|---|---|---|---|
| Xbar 图 | X̿ | X̿ + A₃·S̄ | X̿ − A₃·S̄ |
| S 图 | S̄ | B₄·S̄ | B₃·S̄ |
过程标准差估计换成:σ̂ = S̄ / c₄
c₄ 是无偏修正系数。为啥要修正?因为 s 是方差的无偏估计的平方根,而"平方根的期望"不等于"期望的平方根"——E(s) = c₄σ,s 天生略微低估 σ。n 小的时候低估很厉害(n=2 时 c₄=0.7979,低估两成),n 大了才慢慢收敛到 1。
2.3 常数表(A₃ / c₄ / B₃ / B₄)
| n | A₃ | c₄ | B₃ | B₄ |
|---|---|---|---|---|
| 2 | 2.659 | 0.7979 | 0 | 3.267 |
| 3 | 1.954 | 0.8862 | 0 | 2.568 |
| 4 | 1.628 | 0.9213 | 0 | 2.266 |
| 5 | 1.427 | 0.9400 | 0 | 2.089 |
| 6 | 1.287 | 0.9515 | 0.030 | 1.970 |
| 8 | 1.099 | 0.9650 | 0.185 | 1.815 |
| 10 | 0.975 | 0.9727 | 0.284 | 1.716 |
| 12 | 0.886 | 0.9776 | 0.354 | 1.646 |
| 15 | 0.789 | 0.9823 | 0.428 | 1.572 |
| 20 | 0.680 | 0.9869 | 0.510 | 1.490 |
| 25 | 0.606 | 0.9896 | 0.565 | 1.435 |
有个细节很多人没留意:从 n=6 开始 B₃ 就大于 0 了,S 图开始有下控制限。这条下限不是摆设——变异突然变小同样是异常信号,常见于量具卡死、数据被"修饰"、或者某个自动检测通道离线了还在填上一次的值。R 图在 n≤6 时下限恒为 0,抓不到这类事。
2.4 什么时候必须上 Xbar-S
三种情形,别犹豫:
- n ≥ 10,极差的信息效率已经掉到 85% 以下,继续用 R 是浪费;
- 数据是自动采集的,子组内全量数据本来就现成,算 s 是计算机一行代码的事,没有手算负担;
- 子组大小不固定(比如按时间窗取样,一窗多少件不确定),R 的常数表按 n 查、n 变了限就得变,而 s 可以用加权合并的方式统一处理,实操上顺畅得多。
反过来,n ≤ 5 且人工手算的场合,老老实实用 R 图:效率损失不到 5%,但操作工拿计算器就能算,培训成本低一大截。这是工程权衡,不是学术优劣。
三、车间真实案例:灌装净含量的 Xbar-S 手算
产品:500 mL 酱油瓶装,内控规格净含量 500 ± 1.5 g(法规限更宽,这是企业内控)。在线检重,每 5 分钟取连续 10 瓶为一个子组,取 10 组做试算限。
第一步:先把一组的 s 手算一遍,别只会按计算器
第 1 组的 10 个数(g): 500.2、499.6、500.5、499.9、500.1、499.7、500.3、500.0、499.8、500.4
求和:5000.5 → X̄₁ = 5000.5 / 10 = 500.05 g
各点偏差与平方:
| xⱼ | xⱼ − X̄ | (xⱼ − X̄)² |
|---|---|---|
| 500.2 | +0.15 | 0.0225 |
| 499.6 | −0.45 | 0.2025 |
| 500.5 | +0.45 | 0.2025 |
| 499.9 | −0.15 | 0.0225 |
| 500.1 | +0.05 | 0.0025 |
| 499.7 | −0.35 | 0.1225 |
| 500.3 | +0.25 | 0.0625 |
| 500.0 | −0.05 | 0.0025 |
| 499.8 | −0.25 | 0.0625 |
| 500.4 | +0.35 | 0.1225 |
| Σ | 0 | 0.8250 |
s₁ = √(0.8250 / 9) = √0.091667 = 0.303 g
顺带看一眼:这组的极差 R₁ = 500.5 − 499.6 = 0.9 g。R 只认了 499.6 和 500.5 这两瓶,其余 8 瓶的信息全在 s 里,不在 R 里。
第二步:10 组的汇总
| 子组 | X̄ (g) | s (g) |
|---|---|---|
| 1 | 500.05 | 0.303 |
| 2 | 499.98 | 0.288 |
| 3 | 500.12 | 0.315 |
| 4 | 500.02 | 0.297 |
| 5 | 499.95 | 0.331 |
| 6 | 500.08 | 0.276 |
| 7 | 500.00 | 0.309 |
| 8 | 500.06 | 0.294 |
| 9 | 499.97 | 0.322 |
| 10 | 500.03 | 0.285 |
Σ(X̄ − 500) = 0.05 − 0.02 + 0.12 + 0.02 − 0.05 + 0.08 + 0 + 0.06 − 0.03 + 0.03 = 0.26 X̿ = 500 + 0.26 / 10 = 500.026 g
Σs = 3.020 → S̄ = 3.020 / 10 = 0.302 g
第三步:套常数(n=10:A₃=0.975,B₃=0.284,B₄=1.716,c₄=0.9727)
S 图先判: UCL_S = B₄·S̄ = 1.716 × 0.302 = 0.518 g LCL_S = B₃·S̄ = 0.284 × 0.302 = 0.086 g 10 个 s 值范围 0.276~0.331,全在 0.086~0.518 之间,S 图受控,可以往上看 Xbar。
Xbar 图: A₃·S̄ = 0.975 × 0.302 = 0.2945 UCL_X̄ = 500.026 + 0.2945 = 500.320 g LCL_X̄ = 500.026 − 0.2945 = 499.732 g
过程标准差与能力: σ̂ = S̄ / c₄ = 0.302 / 0.9727 = 0.3105 g Cp = T / 6σ̂ = 3.0 / (6 × 0.3105) = 3.0 / 1.863 = 1.61 Cpu = (501.5 − 500.026) / (3 × 0.3105) = 1.474 / 0.9315 = 1.58 Cpl = (500.026 − 498.5) / 0.9315 = 1.526 / 0.9315 = 1.64 Cpk = 1.58
第四步:跟 n=5 的老方案比一比
原方案从 10 瓶里抽 5 瓶做 Xbar-R,控制限半宽 = 3σ/√5 = 3 × 0.3105 / 2.236 = 0.417 g; 新方案 n=10,半宽 = 3σ/√10 = 3 × 0.3105 / 3.162 = 0.295 g。
控制带收窄 29%。后来那次灌装头结垢造成的 0.4 g 系统性偏移,老方案下 X̄ 落在 500.43,还在 ±0.417 的限内不报警;新方案下 500.32 就报警了。同样的数据、同样的钱,只是换了张图,就把漏报变成了报警。
四、常见误区提醒
- 算 s 时用错了分母。 Excel 里 STDEV.S 是 n−1,STDEV.P 是 n,用错一个,n=10 时 s 会小 5%,限跟着窄 5%,一天多出好几次假报警。手算认准 n−1,公式里那个自由度不是装饰。
- 忘了 c₄,直接拿 S̄ 当 σ。 n=10 时 c₄=0.9727,直接用 S̄ 会低估 σ 约 2.8%,Cp 被高估 2.8%——单看不多,但客户 PPAP 卡在 1.33 边缘时,这点差额足够让你从"合格"变"不合格",或者反过来被抓造假。σ̂ = S̄/c₄,这个除法不能省。
- S 图只画上限,不画下限。 n≥6 时 B₃>0,下限是有意义的。S 突然掉到 LCL 以下,第一嫌疑是数据不真实(复制粘贴上一组、传感器离线、量具卡死),第二嫌疑才是过程真的变好了——真变好了也得查明原因、固化下来、重算限。
五、小结 & 互动提问
R 图省事,S 图省数据。子组一旦上到 10 及以上,或者数据本来就是机器自动采的,Xbar-S 才是正经姿势:估计更准、限更窄、还多了一条能抓假数据的 S 图下限。换图这件事,成本几乎为零,收益实打实。
互动提问:你产线上有没有那种"全量采集了,却只挑两个点算极差"的工序?把那批历史数据拉出来重算一遍 Xbar-S,看看控制限能收窄多少——欢迎把前后对比数发出来。
如需配套互动练习、培训课件或软件试用,可搜索「东方大易」或访问大易官网 www.eastdayi.com(苏州东方大易管理咨询有限公司,电话 0512-65561989)联系客服获取。