移动极差 MR 的计算陷阱与修正
一、先讲个真事
一家做电镀的厂子,镀层厚度用 I-MR 图管,某天开始疯狂报警,一个班报七八次。班长找我:机床没修、槽液没换、人也没换,怎么突然这么多警?
我把他们的原始表格要过来一看,MR 那一列的数值全都偏小得离谱。顺着公式一查——他们算的是 |xᵢ − X̄|,不是 |xᵢ − xᵢ₋₁|。
一个字之差:前者是"单值到中心线的距离",后者才是"相邻两点的落差"。前者算出来的平均值大约只有后者的一半,M̄R 腰斩,控制限跟着腰斩,图上不报警才怪。
改回来之后,UCL 从 8.755 回到 9.103,报警立刻降到正常水平。一个小小的下标写错,让一条产线折腾了两周。
二、核心知识点拆解
2.1 陷阱一:第一个点填 0
k 个单值,能算出的 MR 只有 k−1 个,第一个点没有前驱,MR 必须留空。可 Excel 表格里那个空格看着别扭,很多人顺手填个 0,或者软件默认补 0。
后果是双重的:一是多出一个假的 0 值把 M̄R 拉低,二是分母从 k−1 变成了 k。
拿本文案例的 15 个点算(详见第三节):正确 M̄R = 3.7/14 = 0.2643;填 0 之后变成 3.7/15 = 0.2467,低估 6.7%。控制限跟着窄 6.7%,一年多出来的假报警够班组开好几次质量分析会。
k 越小坑越深:k=10 时低估 10%,k=6 时低估 17%。小批量本来数据就少,这个坑踩不起。
2.2 陷阱二:分母除以 k 而不是 k−1
这跟上一条是同一枚硬币的两面。哪怕没填那个 0,求和后手一滑除以点数 k,效果一模一样。记牢:ΣMR ÷ (k−1),分子有几项分母就写几。
2.3 陷阱三:把数据排过序
这是最隐蔽、破坏力最大的一个。有人为了"看得清楚"在 Excel 里按大小排了序,或者导出时忘了按时间戳排。
MR 的全部意义建立在"时间顺序"上。排序之后,相邻两点的差被压到最小,M̄R 会缩到只剩零头。
本文案例的 15 个数排序后,M̄R 从 0.2643 掉到 0.0429,控制限半宽从 ±0.703 缩到 ±0.114,15 个点里有 9 个直接飞出限外。图上一片血红,可过程一点毛病没有。
I-MR 的数据,只能按采集时间排,任何重排都是犯罪现场。
2.4 陷阱四:跨界的那个 MR
换模、换批料、换槽液、设备大修后重启、停机过夜再开——这些断点前后的两个数据,本质上属于两个不同的过程状态。跨越断点算出来的那个 MR,既不代表旧状态的组内变异,也不代表新状态的,它代表的是"变化本身"。
把它算进 M̄R,等于把阶跃量当成固有波动,限被撑宽,图从此不报警。更讽刺的是:这个撑大的限往往刚好把撑大它的那个跳变点罩在里面——嫌疑人自己开了张不在场证明。
正确处理:断点处断链,跨界 MR 不参与 M̄R 计算,图上留空并标注原因。有条件的话,断点之后重新建限(第 28 篇细讲)。
2.5 陷阱五:MR 图上不能套游程规则
这条知道的人不多。相邻两个 MR 共用同一个数据点:
中间那个 xᵢ 两边都用了,所以 MRᵢ 和 MRᵢ₊₁ 天生就是相关的,不满足独立性假设。
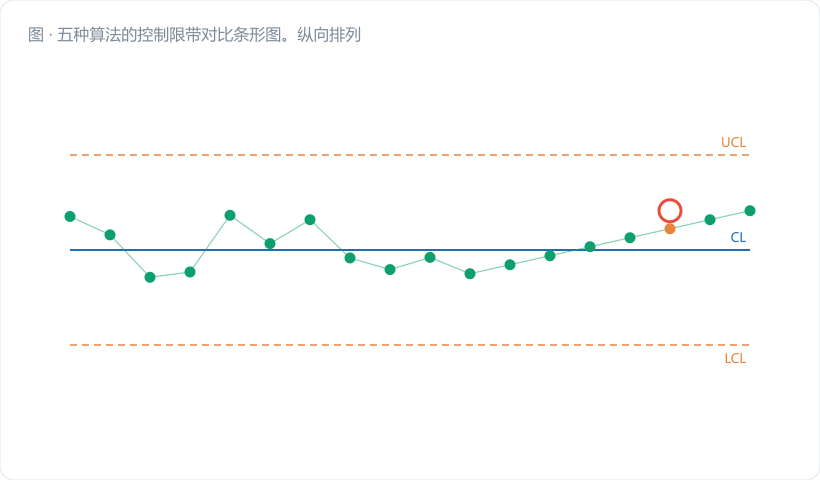
而"连续 9 点同侧""连续 6 点递增"这类游程规则(判异准则 2~8),它们的报警概率是按独立同分布推导出来的。把这些规则套到自相关的 MR 序列上,假报警率会显著高于设计值。
实操规矩:MR 图只用准则 1(单点超出控制限),其余游程规则一律不用。I 图上倒是可以放心用全套准则。
2.6 陷阱六:MR 对缓慢漂移基本失明
MR 抓的是"相邻两点的落差"。要是过程每批只漂 0.05,相邻落差就是 0.05,完全淹没在随机噪声里,MR 图上风平浪静。可 15 批下来累计漂了 0.75,I 图上早就是一条明显的爬坡了。
所以 MR 图的定位要摆正:它是"突变探测器",不是"趋势探测器"。渐变靠 I 图 + 判异准则(连续 6 点递增、连续 9 点同侧),别指望 MR。
2.7 修正手段:中位移动极差法
M̄R 是所有 MR 的算术平均,一个飞点就能把它拉高一大截。抗干扰的替代方案是中位移动极差:
其中 M̃R 是所有 MR 的中位数,0.954 是 n=2 时的 d₄ 系数(对应中位极差的期望修正)。
效果有多明显?看本文案例:一个数据被多打了一位(8.7 误记成 9.7),
- 均值法:M̄R 从 0.2643 涨到 0.4071,飙了 54%;
- 中位法:M̃R 保持 0.25 纹丝不动。
在数据录入质量不太可控的现场(手抄、口报、多人填表),中位法能省掉"该不该剔这点"的扯皮。代价是效率略低,换来稳。
三、车间真实案例:一组镀层厚度,五种算法五个结果
数据:某零件镀层厚度(μm),按时间顺序采集 15 个单值。
| 序号 | x | MR(正确) |
|---|---|---|
| 1 | 8.2 | — |
| 2 | 8.5 | 0.3 |
| 3 | 8.3 | 0.2 |
| 4 | 8.6 | 0.3 |
| 5 | 8.4 | 0.2 |
| 6 | 8.1 | 0.3 |
| 7 | 8.5 | 0.4 |
| 8 | 8.3 | 0.2 |
| 9 | 8.7 | 0.4 |
| 10 | 8.4 | 0.3 |
| 11 | 8.2 | 0.2 |
| 12 | 8.6 | 0.4 |
| 13 | 8.4 | 0.2 |
| 14 | 8.5 | 0.1 |
| 15 | 8.3 | 0.2 |
Σx = 126.0 → X̄ = 126.0 / 15 = 8.40 μm ΣMR = 3.7,共 14 个 MR → M̄R = 3.7 / 14 = 0.2643 μm
算法 A(正确)
σ̂ = 0.2643 / 1.128 = 0.2343 μm E₂·M̄R = 2.660 × 0.2643 = 0.7030 UCL_I = 8.40 + 0.7030 = 9.103 LCL_I = 8.40 − 0.7030 = 7.697 UCL_MR = 3.267 × 0.2643 = 0.8634 15 个点全在限内,MR 最大 0.4,受控。
算法 B(首点填 0 / 分母除以 15)
M̄R = 3.7 / 15 = 0.2467(低估 6.7%) UCL_I = 8.40 + 2.660 × 0.2467 = 9.056 LCL_I = 7.744 UCL_MR = 3.267 × 0.2467 = 0.8059 限窄了 0.047 μm。本例数据干净还没顶出去,但门槛已经悄悄降了。
算法 C(错用 |xᵢ − X̄|)
Σ|xᵢ − 8.40| = 0.2+0.1+0.1+0.2+0+0.3+0.1+0.1+0.3+0+0.2+0.2+0+0.1+0.1 = 2.0 "M̄R" = 2.0 / 15 = 0.1333(只有正确值的一半) UCL_I = 8.40 + 2.660 × 0.1333 = 8.755 LCL_I = 8.045 往回一比对:第 6 点 8.1 < 8.045 超下限,第 9 点 8.7 < 8.755 差点也出去。这就是开头那家电镀厂"一个班报七八次"的真相。
算法 D(数据被按大小排过序)
排序后:8.1, 8.2, 8.2, 8.3, 8.3, 8.3, 8.4, 8.4, 8.4, 8.5, 8.5, 8.5, 8.6, 8.6, 8.7 MR:0.1, 0, 0.1, 0, 0, 0.1, 0, 0, 0.1, 0, 0, 0.1, 0, 0.1 → ΣMR = 0.6 M̄R = 0.6 / 14 = 0.0429 UCL_I = 8.40 + 2.660 × 0.0429 = 8.514 LCL_I = 8.286 15 个点里,8.2、8.1、8.6、8.7、8.5… 一大半飞出限外。图彻底废掉,还会让人误以为过程失控去瞎调机。
算法 E(含一个录入错误 8.7→9.7,比较均值法与中位法)
MR 序列变成:0.3, 0.2, 0.3, 0.2, 0.3, 0.4, 0.2, 1.4, 1.3, 0.2, 0.4, 0.2, 0.1, 0.2
- 均值法:ΣMR = 5.7 → M̄R = 5.7/14 = 0.4071(比正确值高 54%)→ σ̂ = 0.361,UCL_I = 8.4+1.083 = 9.48,限被撑宽 54%,从此对真实异常失明;
- 中位法:MR 中位数 M̃R = 0.25(与无错误时完全一致)→ σ̂ = 0.25/0.954 = 0.262,UCL_I ≈ 8.4 + 3×0.262 = 9.19,几乎不受污染。
五种算法汇总对照
| 算法 | M̄R 或 M̃R | UCL_I | LCL_I | 相对正确限的偏差 | 后果 |
|---|---|---|---|---|---|
| A 正确 | 0.2643 | 9.103 | 7.697 | — | 受控,判读可信 |
| B 首点填 0 | 0.2467 | 9.056 | 7.744 | 窄 6.7% | 假报警缓慢增多 |
| C 减总均值 | 0.1333 | 8.755 | 8.045 | 窄 49% | 假报警泛滥 |
| D 排过序 | 0.0429 | 8.514 | 8.286 | 窄 84% | 图完全失效 |
| E 含录入错·均值法 | 0.4071 | 9.483 | 7.317 | 宽 54% | 真异常漏报 |
| E 含录入错·中位法 | 0.25 | ≈9.19 | ≈7.61 | 宽 ≈4% | 基本免疫 |
一张表看下来你就明白了:MR 这列填错不是"差不多",能把控制限拉扯到 84% 偏差。
四、常见误区提醒
- 在 MR 图上套"连续 9 点同侧""连续 6 点递增"。 相邻 MR 共用数据点、天然相关,游程规则的概率前提不成立。MR 图只认准则 1:单点超 UCL。要抓趋势,请到 I 图上抓。
- 换批、换模、大修之后的那个 MR 照算不误。 跨界 MR 反映的是状态切换,不是过程固有波动。它会把控制限撑宽到刚好罩住自己,这是所有 MR 陷阱里最讽刺的一个。断点处必须断链。
- MR 一长串等于 0 还觉得过程稳如老狗。 连续多个 MR = 0,八成是量具分辨力不够(读数最小刻度 ≥ 过程波动),把真实波动抹平了。分辨力应不大于过程变差的 1/10,否则 M̄R 被人为压低,限过窄,假报警一堆——先去校量具,别急着调机床。
五、小结 & 互动提问
MR 的公式简单到一行,但它的每一个细节都在跟你较劲:留空不填零、分母 k−1、按时间排、跨界断链、只用准则 1、脏数据上中位法。这六条抄下来贴在 I-MR 表格的抬头上,能省掉你未来两年一半的扯皮。
互动提问:现在就打开你手边任意一份 I-MR 记录表,看三件事——第一行 MR 是空的还是 0?数据有没有被排过序?换批那一行的 MR 是不是照算了?三条里中一条,你的控制限就已经不对了。中了几条?
如需配套互动练习、培训课件或软件试用,可搜索「东方大易」或访问大易官网 www.eastdayi.com(苏州东方大易管理咨询有限公司,电话 0512-65561989)联系客服获取。