能力分级:Cpk≥1.33 是金标准吗
一、先说结论
Cpk ≥ 1.33 是行业里最通行的验收线,但它不是物理定律,是一条历史约定 + 风险权衡的产物。
它的来历很朴素:Cpk = 1.33 意味着均值到最近规格限有 4 个 σ 的距离(Z = 4),单侧理论不良约 32 PPM。这个水平在上世纪汽车业被普遍认为"留了一个 σ 的缓冲,能扛住日常小漂移",于是就定下来了。
咱们该怎么看这条线?我的态度是三句话:
- 它是底线,不是目标。 达到 1.33 只说明"暂时不用上 100% 检验",不等于万事大吉。
- 它得配样本量看。 30 件算出的 1.35 和 300 件算出的 1.35,可信度差着好几个档次。
- 它得配后果严重度看。 一个不影响功能的外观尺寸和一个安全件的紧固扭矩,凭什么用同一条线?
二、核心知识点拆解
2.1 分级表:先把通行标尺摆出来
| Cpk 区间 | 等级 | 单侧 PPM 量级 | 通常怎么处置 |
|---|---|---|---|
| < 1.00 | 不可接受 | > 1,350 | 100% 检验 + 立项改善 + 通知客户 |
| 1.00 ~ 1.33 | 勉强 / 需改善 | 32 ~ 1,350 | 加严监控频次 + 制定改善计划 |
| 1.33 ~ 1.67 | 可接受 | 0.3 ~ 32 | 常规控制图,按控制计划执行 |
| 1.67 ~ 2.00 | 良好 | < 0.3 | 可考虑放宽抽样频次 |
| ≥ 2.00 | 优异 | ≈ 0 | 评估降检 / 转向其他瓶颈工序 |
再叠一层"该报哪个指数"的行业惯例:
| 阶段 | 指数 | 常见门槛 | 为什么是这个值 |
|---|---|---|---|
| PPAP 初始过程研究 | Ppk | ≥ 1.67 | 数据少、未证明长期稳定,要留安全余量 |
| 量产日常 | Cpk | ≥ 1.33 | 已受控,短期能力可信 |
| 安全/法规特性(S/C 类) | Cpk | ≥ 1.67 甚至更高 | 失效后果严重,风险容忍度低 |
| 设备验收 | Cmk | ≥ 1.67(常见 1.67~2.0) | 设备本身要比过程留更多余量 |
| 属性数据(计数型) | — | 按不合格率直接判 | 走 ISO 22514-5 的路子,不套 Cpk |
注意 Ppk 门槛(1.67)比 Cpk(1.33)高这件事——不是双标,是因为初始阶段不确定性大,用更高的点估计换取相同的实际信心。
2.2 最容易被忽略的一刀:置信区间
这是本篇最想让你带走的东西。
你算出来的 Cpk 是个点估计,是从有限样本里估出来的,它自己也带着不确定性。样本越少,这个估计越飘。
工程上常用的 95% 单侧置信下限近似公式:
Cpk_L = Ĉpk × [ 1 − 1.645 × √( 1/(9n·Ĉpk²) + 1/(2(n−1)) ) ]
(n 是总样本量;要 90% 置信就把 1.645 换成 1.282,99% 换成 2.326)
拿 Ĉpk = 1.33 代进去,看看不同样本量下的置信下限:
| 样本量 n | Ĉpk 点估计 | 95% 置信下限 Cpk_L | 敢不敢说"达标" |
|---|---|---|---|
| 30 | 1.33 | 1.03 | 不敢 |
| 50 | 1.33 | 1.10 | 不敢 |
| 100 | 1.33 | 1.17 | 悬 |
| 125 | 1.33 | 1.18 | 悬 |
| 200 | 1.33 | 1.21 | 勉强 |
| 500 | 1.33 | 1.26 | 接近了 |
你品品这张表:哪怕取了 500 件,Ĉpk = 1.33 的置信下限也只有 1.26,严格说都没真正证明"Cpk ≥ 1.33"。
反过来问:要让 125 件样本的置信下限达到 1.33,点估计得多高?代进公式试算,答案约 1.50。
所以我在车间给团队定的内部线是:点估计 1.50 才算"稳稳达标 1.33"。 这不是苛刻,这是把统计的不确定性提前买单。
2.3 光看 Cpk 是不够的,得看四件事
拿到一个能力指数,我习惯配着四个维度一起判:
| 维度 | 问自己 | 不满足会怎样 |
|---|---|---|
| 样本量与置信度 | n 够不够?置信下限过线没? | 点估计好看,实际不达标 |
| 稳定性(Cpk vs Ppk) | R_stab 超 1.3 没? | 今天够,明天漂过去就不够 |
| 正态性 | 数据偏不偏?有没有自然边界? | Cpk 被高估,风险被低估 |
| 测量系统 | %GRR 多少?分辨力够不够? | σ̂ 里混了量具波动,指数失真 |
这四条任何一条不过关,那个 Cpk 数字的含金量就得打折。 我见过太多"Cpk 1.6 但 %GRR 42%"的报告——量具都看不清的东西,能力算得再准也是假的。
2.4 那 1.33 到底该不该守
该守,但要动态地守。我的做法是按后果严重度分档:
- 安全件、法规件(S 类):Cpk ≥ 1.67,且置信下限要 ≥ 1.33
- 重要功能件(C 类):Cpk ≥ 1.33,置信下限 ≥ 1.10
- 一般特性:Cpk ≥ 1.33 点估计即可
- 次要外观、非配合尺寸:可放宽到 1.00,但必须有控制图在看
再往下还有一层现实考量:如果一道工序的能力受物理极限所限就是上不去(比如公差本来就给得过紧),死磕 Cpk 没意义,正确出路是拿数据去跟设计谈公差放宽,或者上 100% 自动检测把风险堵在出厂前。 指数是手段,把不良挡住才是目的。
三、车间真实案例:1.35 到底达没达标
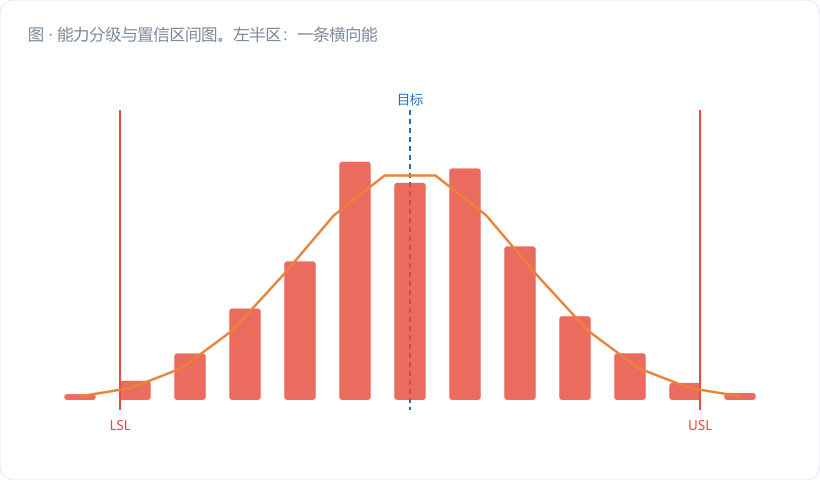
回到开头那道工序。加工变速箱同步器齿套的内花键跨棒距,规格 38.500 ± 0.040 mm(LSL = 38.460,USL = 38.540)。
第一轮(评审会上那份):6 个子组 × n = 5,共 30 件。x̄ = 38.5085,σ̂ = 0.00776。
| 项目 | 计算 | 结果 |
|---|---|---|
| CPU | (38.540 − 38.5085)/(3×0.00776) = 0.0315/0.02328 | 1.353 |
| CPL | (38.5085 − 38.460)/0.02328 = 0.0485/0.02328 | 2.083 |
| Ĉpk | min | 1.35 |
| 95% 置信下限 | 1.35 × [1 − 1.645√(1/(9×30×1.8225) + 1/58)] | 1.04 |
手算一下那个根号里的东西: 1/(9 × 30 × 1.8225) = 1/492.1 = 0.002032 1/(2 × 29) = 1/58 = 0.017241 和 = 0.019273,开方 = 0.13883,× 1.645 = 0.22838 Cpk_L = 1.35 × (1 − 0.22838) = 1.35 × 0.77162 = 1.04
点估计 1.35 达标,置信下限 1.04 不达标。 意思是:以现有 30 件的证据,你只能说"这道工序的真实 Cpk 有 95% 的把握不低于 1.04",离 1.33 还差得远。
第二轮(补充取样):扩到 25 子组 × n = 5,共 125 件,横跨三个班次、两个料批。
x̄ = 38.5102,σ̂ = 0.00891(比第一轮大——第一轮那 30 件是同班同刀,波动被低估了)
| 项目 | 结果 |
|---|---|
| CPU | (38.540 − 38.5102)/(3×0.00891) = 0.0298/0.02673 = 1.115 |
| Ĉpk | 1.12 |
| 95% 置信下限 | 0.99 |
| s_overall | 0.01048 |
| Ppk | 0.0298/(3×0.01048) = 0.948 |
| R_stab | 0.01048/0.00891 = 1.18(尚可) |
真相浮出水面:扩样后 Cpk 从 1.35 掉到 1.12。第一轮那个漂亮数字,纯粹是样本太少 + 取样条件太理想造出来的。
整改:拉削油温波动和拉刀刃磨周期不统一是主因。上恒温油箱 + 拉刀按件数强制刃磨,同时把均值往中心拉(原来偏上 0.010)。
复测(125 件):x̄ = 38.5012,σ̂ = 0.00702
| 项目 | 结果 |
|---|---|
| CPU | (38.540 − 38.5012)/0.02106 = 1.842 |
| CPL | (38.5012 − 38.460)/0.02106 = 1.957 |
| Ĉpk | 1.84 |
| 95% 置信下限 | 1.62 ✔ |
| Ppk | 1.71 |
点估计 1.84,置信下限 1.62,这才叫真的达标 1.33,而且余量足够扛住日常漂移。
四、常见误区提醒
- 拿 30 件的点估计当验收结论。 小样本的 Cpk 波动极大,点估计过线 ≠ 真实能力过线。任何能力结论都该同时报样本量和置信下限,缺一个就是信息不完整。
- 把 1.33 当成天花板,达标就不管了。 1.33 是"允许你不上全检"的门槛,不是"这道工序已经优秀"的证书。能力有余量的工序,抗漂移能力才强,客户变更节拍、换料、换班的时候才不会立刻翻车。
- 所有特性一刀切用 1.33。 安全件和外观尺寸用同一条线,等于既浪费了资源又留了风险。按后果严重度分级设定门槛,把力气花在真正要命的特性上,这才是控制计划该有的样子。
五、小结 & 互动提问
Cpk ≥ 1.33 是条好线,用了几十年自有它的道理。但它只是一条线,不是全部真相。真正靠谱的能力判定,得把样本量、置信下限、稳定性、正态性、测量系统这五样一起摆上桌。
模块六走到这儿,从"能力是什么"讲到"能力算出来该怎么信",算是绕了一圈回到原点:指数是工具,判断是人的事。 别让一个数字替你做决定。
互动提问:拿你手上任意一份 Cpk 报告,找到它的样本量 n,用 Cpk_L = Ĉpk[1 − 1.645√(1/(9n·Ĉpk²) + 1/(2(n−1)))] 算一下置信下限。如果这个下限掉到了 1.33 以下,你打算是补样本、还是先去做改善?
如需配套互动练习、培训课件或软件试用,可搜索「东方大易」或访问大易官网 www.eastdayi.com(苏州东方大易管理咨询有限公司,电话 0512-65561989)联系客服获取。