小样本能力评估:数据不够怎么办
一、先说结论
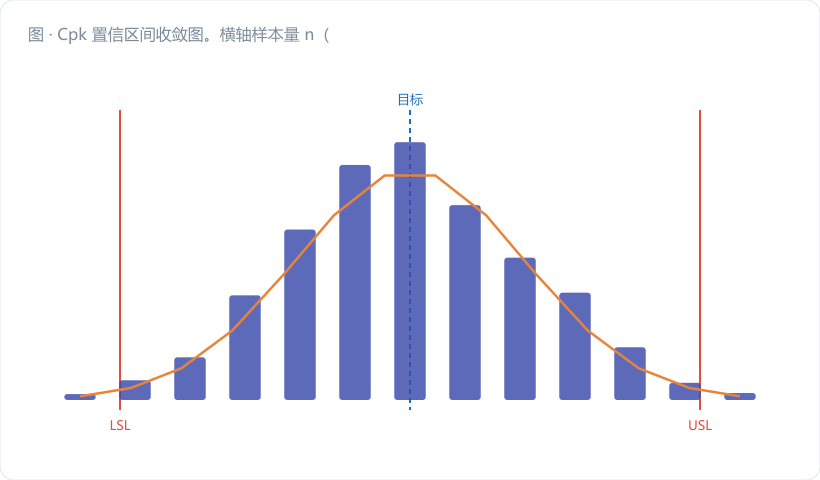
Cpk 和 Ppk 是估计值,不是测量值。 你算出来的那个 1.82,跟真值之间隔着一整个抽样分布。样本越小,这个分布越宽,宽到什么程度?给你个数感受一下:
n = 10 的时候,点估计 1.33 对应的 95% 置信下限只有 0.79。
也就是说,拿 10 个数据算出 1.33,你连"这个过程能不能到 0.8"都不敢打包票。可现实里有多少初期能力报告,就是拿十来个件凑出来的?
小样本的正确姿势不是"想办法把数字算大点",而是这三件事:
- 报点估计的同时,必须报置信下限;
- 数据非正态或者形状怪时,用 Bootstrap 求经验区间;
- 样本实在不够,就换证据链——机器能力 Cm、同族件历史数据、防错措施一起上,别硬凑一个 Ppk。
二、核心知识点拆解
2.1 Cpk 的抽样分布有多宽
Ĉpk 的标准误有个业内常用的近似式(Bissell 近似):
$$SE(\hat{C}_{pk}) \approx \hat{C}_{pk}\sqrt{\frac{1}{9n\hat{C}_{pk}^2} + \frac{1}{2(n-1)}}$$
单侧 95% 置信下限:
$$LCL_{95\%} = \hat{C}_{pk} - 1.645 \times SE(\hat{C}_{pk})$$
把 Ĉpk = 1.33 代进去,看不同样本量下的置信下限:
| 样本量 n | SE | 95% 置信下限 | 这个下限意味着 |
|---|---|---|---|
| 10 | 0.331 | 0.79 | 等于什么都没证明 |
| 25 | 0.203 | 1.00 | 连 1.0 都刚够着 |
| 30 | 0.185 | 1.03 | PPAP 常见样本量 |
| 50 | 0.142 | 1.10 | 稍微像话了 |
| 100 | 0.100 | 1.17 | 能拿出手 |
| 200 | 0.071 | 1.21 | 接近可信 |
看最后一行:哪怕 200 个数据,点估计 1.33 的置信下限也才 1.21。 能力指数这东西天生"贵",想把它算准,要的样本量比大多数人想象的多一个量级。
反过来讲,这张表也解释了一件长期让人困惑的事——为啥 PPAP 初期能力要求 1.67,量产 Cpk 只要 1.33? 那 0.34 的差额,一部分是给长期变差留的余量,另一部分就是给小样本的统计不确定性买单。
2.2 Bootstrap:不假设正态的笨办法
上面那个公式有个前提——数据近似正态。真实车间里,形位公差、单侧特性、经过全检筛过的数据,都不正态。这时候 Bootstrap 更靠谱。
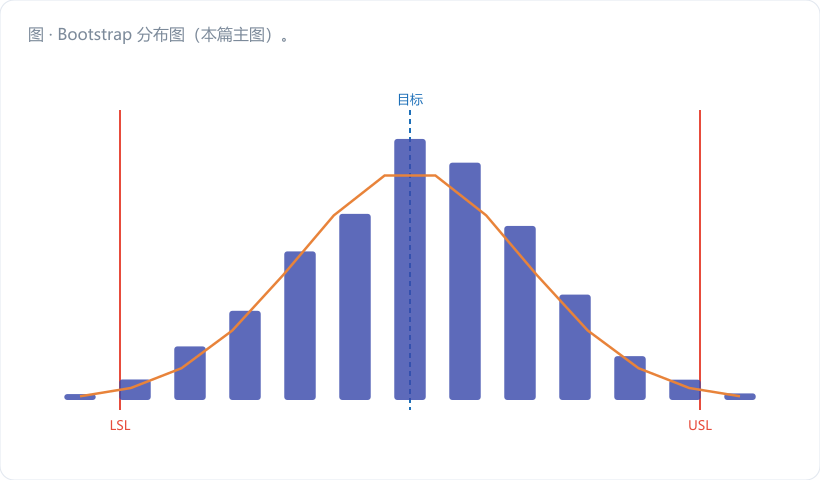
Bootstrap 的操作土得掉渣,但特别管用:
- 手上有 n 个原始数据;
- 有放回地从这 n 个里随机抽 n 个,组成一份"重抽样";
- 用这份重抽样算一个 Ppk;
- 把 2、3 步重复 2 000 ~ 20 000 次,得到一大堆 Ppk;
- 把它们排序,取第 2.5% 和第 97.5% 位置的值,就是 95% 经验置信区间。
它的好处是完全不问分布长什么样,缺点是"只能在已有数据里打转"。 原始样本没抓到的尾部,Bootstrap 也变不出来,所以小样本下它的区间会偏窄、偏乐观。实操建议:Bootstrap 结果和解析近似都算一遍,取更保守的那个报给客户。
2.3 样本实在不够时的四条替代路线
- 路线一:同族件合并(短流程标准化)。 多品种小批量车间的救命稻草。把不同零件的数据做标准化变换 Z = (x − 目标值)/公差,量纲一样了就能合并画图、合并估 σ。前提是这些零件确实走同一台设备、同一套工艺。
- 路线二:借历史先验。 同一台设备、同一类特性,过去两年积累了成千上万个数据,σ 是稳定已知的。新件只需少量样本确认"均值在哪、σ 没变大",能力就能推出来。
- 路线三:机器能力顶上。 新设备没量产数据,但可以做 Cm/Cmk 研究(见第 62 篇)。50 件连续加工的 Cm = 2.0,是很硬的证据,比 10 件算出来的 Ppk 有说服力得多。
- 路线四:换维度补证据。 能力实在证不出来,就上 100% 检测、防错装置、SPC 加严监控,在 PFMEA 里把探测度降下来。跟客户谈的时候,一份"我们知道自己数据不足,所以做了 ABC 三重防护"的方案,远比一个虚高的 1.82 受欢迎。
三、车间真实案例 / 计算过程
新项目零件,关键尺寸 45.00 ± 0.15 mm(LSL 44.85、USL 45.15,T = 0.30)。试产 30 件,客户要求 Ppk ≥ 1.67。
实测统计量:n = 30,x̄ = 45.0050 mm,s = 0.02650 mm
第一步:点估计
上侧:(45.15 − 45.0050)/(3×0.0265) = 0.1450/0.0795 = 1.824 下侧:(45.0050 − 44.85)/(3×0.0265) = 0.1550/0.0795 = 1.950
Ppk = min(1.824, 1.950) = 1.82 ✅ 看着过了
第二步:算标准误
SE = 1.824 × √[ 1/(9×30×1.824²) + 1/(2×29) ] = 1.824 × √(0.0011132 + 0.0172414) = 1.824 × √0.0183546 = 1.824 × 0.13548 = 0.2471
第三步:置信区间
双侧 95%:1.824 ± 1.96 × 0.2471 = (1.34, 2.31) 单侧 95% 下限:1.824 − 1.645 × 0.2471 = 1.42
客户要 1.67,我们的 95% 置信下限只有 1.42。 点估计确实是 1.82,但这份数据不足以在 95% 把握下声称"真值 ≥ 1.67"。客户那位工程师没为难人,他要的东西是对的。
第四步:Bootstrap 验证
对这 30 个原始数据做 20 000 次有放回重抽样,每次算一个 Ppk,排序后取分位数:
| 分位 | Ppk |
|---|---|
| 2.5% | 1.55 |
| 5% | 1.59 |
| 50%(中位) | 1.85 |
| 97.5% | 2.33 |
Bootstrap 给的 95% 区间是 (1.55, 2.33),比解析法的 (1.34, 2.31) 窄了一截——这正是前面说的"小样本下 Bootstrap 偏乐观"。
两个下限,1.42 和 1.55,都够不到 1.67。 结论一致:这 30 件,证不了。
第五步:那要多少件才够
保持点估计 1.824 不变,反解让单侧 95% 下限刚好达到 1.67 所需的 n:
$$1.824 - 1.645 \times 1.824\sqrt{\frac{1}{9n \times 3.327} + \frac{1}{2(n-1)}} \geq 1.67$$
迭代求解得 n ≥ 204。
从 30 件到 204 件,将近 7 倍。 这就是"证明 Ppk ≥ 1.67"的真实价码。
第六步:我们最后怎么谈的
跟客户摊牌,交了这么一套东西:
- Ppk 点估计 1.82,95% 置信下限 1.42,明确写清样本量 n=30 的局限;
- 补做机器能力研究:连续 50 件,Cm = 2.31、Cmk = 2.18,证明设备本身余量充足;
- 承诺量产前 3 个月加严 SPC:子组量从 5 提到 8,每周滚动重算 Ppk,累计到 200 件时提交正式能力报告;
- PFMEA 里对该特性增加在线量仪 100% 监控,探测度从 6 降到 2。
客户批了有条件 PPAP(Interim Approval),三个月后累计 216 件,Ppk = 1.79,95% 下限 1.68,转正式批准。
没有一个数字是编的,只是把"我知道我不知道什么"讲清楚了。 这在客户那边叫专业,在我们这儿叫少挨骂。
四、常见误区提醒
- 拿十来个件算 Cpk 就往报告上写。前面表里写得明明白白,n=10 时点估计 1.33 的置信下限是 0.79。这种报告的信息量约等于零,一旦客户回头查,还落个"数据不实"的口实。样本量低于 25,就别单独用能力指数下结论。
- 小样本用 Cpk 而不用 Ppk。样本少的时候,你压根没法把"组内变差"和"组间变差"分清楚,R̄/d₂ 那套估法失去意义。小样本一律用总体样本 s、报 Ppk,这是最基本的诚实。
- Bootstrap 抽出来的区间当成金标准。案例里 Bootstrap 区间比解析区间窄了 0.21。Bootstrap 不产生新信息,它只是把已有 30 个点重新洗牌。 用它可以,但要知道它在小样本下偏乐观,最好用 BCa 偏差校正,或者干脆和解析法对照取保守值。
- 一看数据不够就找客户要求降低门槛。这是最没出息的一招,而且基本谈不成。正确的谈法是换证据结构:点估计 + 置信下限 + 机器能力 + 加严监控 + 分阶段提交。 客户要的是风险可控,不是那个数字本身好看。
五、小结 & 互动提问
能力指数是个统计估计,它自带一条误差棒。样本少的时候,那条误差棒比指数本身还长——你报一个光秃秃的数字,等于把这条误差棒藏起来了。
小样本不丢人,藏着掖着才丢人。把置信下限一起报出去,把证据链补齐,这才是资深质量工程师和"会用软件点按钮的人"之间的区别。
互动提问:翻出你最近提交的一份 PPAP 能力报告,看看样本量是多少、Ppk 是多少。套一下本文的公式算个 95% 置信下限——它还够得着客户的要求线吗?
如需配套互动练习、培训课件或软件试用,可搜索「东方大易」或访问大易官网 www.eastdayi.com(苏州东方大易管理咨询有限公司,电话 0512-65561989)联系客服获取。